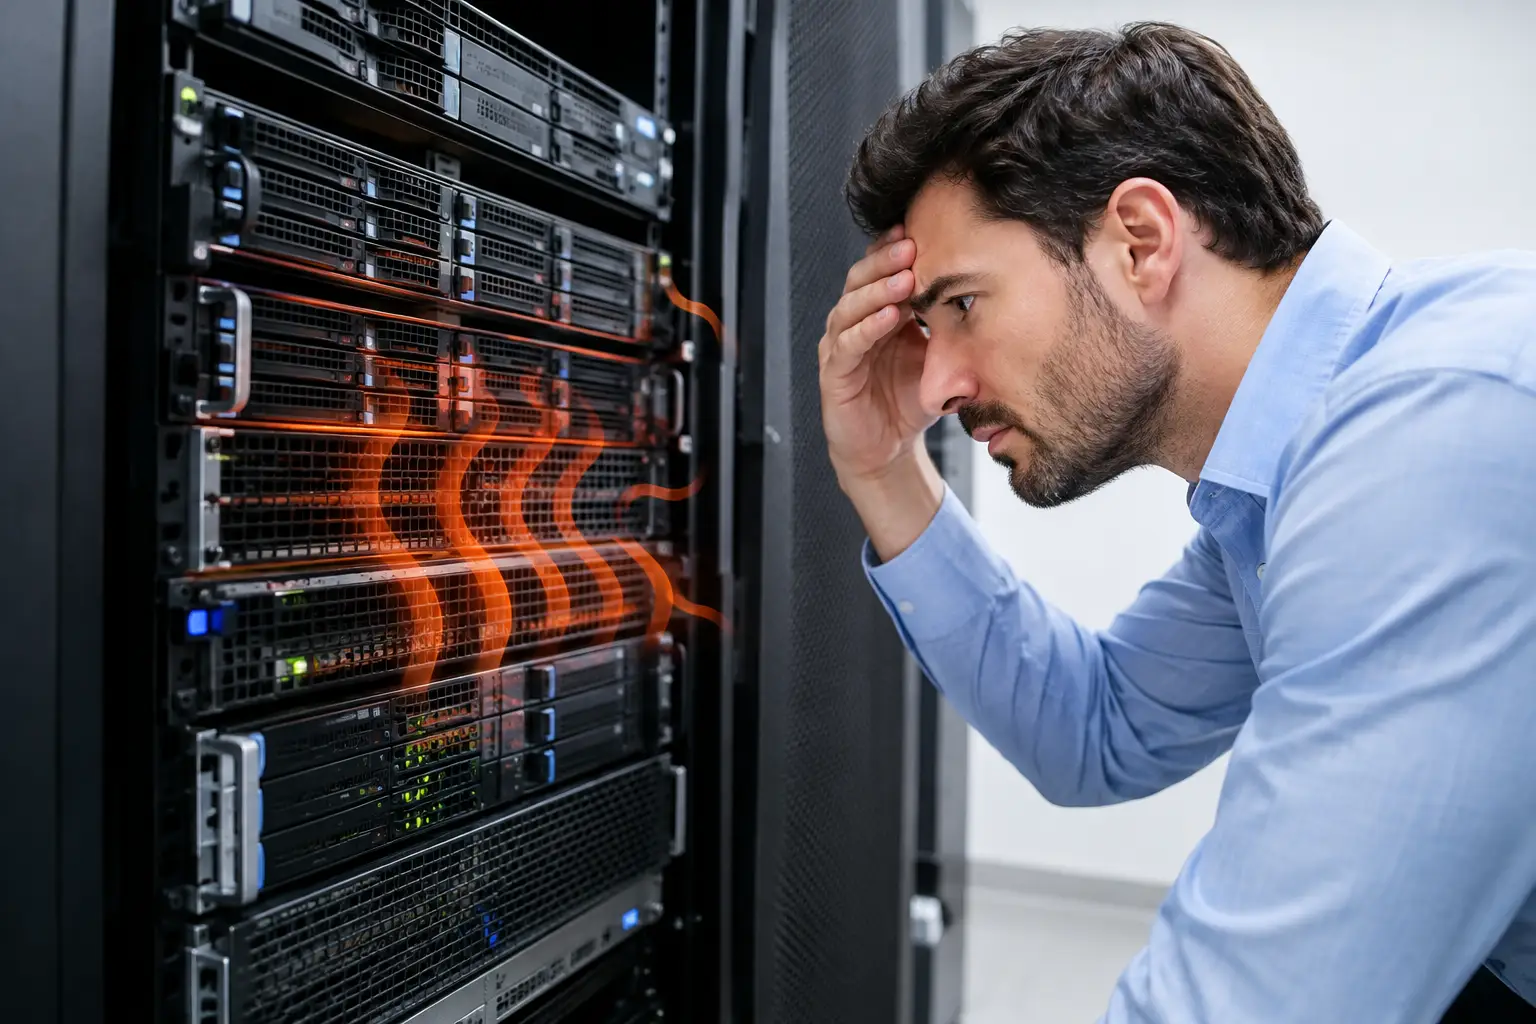
Um alerta térmico em um Dell PowerEdge, HP ProLiant ou IBM não é apenas um aviso para acompanhar no próximo ciclo de manutenção. Quando há um servidor superaquecendo, causas aparentemente simples podem evoluir para redução automática de desempenho, desligamento de emergência, falha de discos e indisponibilidade de aplicações críticas. Em uma operação B2B, o custo não se limita à peça substituída: envolve horas improdutivas, risco aos dados e pressão sobre a equipe de TI.
A temperatura elevada precisa ser tratada como sintoma. O processador pode estar quente porque o fluxo de ar foi bloqueado, porque a carga cresceu além do dimensionamento ou porque um componente de ventilação perdeu eficiência. Corrigir apenas o alerta sem investigar a origem mantém o ambiente exposto. Não arrisque a continuidade do seu negócio por uma falha térmica que poderia ser identificada a tempo.
Servidor superaquecendo: causas que exigem ação
1. Fluxo de ar insuficiente no rack
O ar frio deve entrar pela frente do servidor, atravessar os componentes e sair pela traseira. Parece básico, mas racks com cabos desorganizados, portas perfuradas inadequadas, equipamentos instalados sem padrão e espaços abertos entre servidores comprometem esse caminho. O ar quente expelido pode retornar para a entrada dos equipamentos, elevando a temperatura de forma progressiva.
Em racks de maior densidade, painéis cegos não são acabamento. Eles impedem o recirculamento de ar quente pelos espaços livres. Também vale conferir se há distância suficiente na frente e atrás do rack para circulação, sem caixas, mobiliário ou paredes restringindo a exaustão.
2. Temperatura ambiente acima do projeto
O sistema de ventilação interno do servidor não substitui a climatização da sala. Se o ar de entrada já chega quente, os ventiladores aumentam a rotação, o consumo cresce e ainda assim os sensores podem ultrapassar o limite definido pelo fabricante. Salas técnicas improvisadas, com ar-condicionado residencial ou sem redundância, são fontes recorrentes desse problema.
A medição deve ocorrer na entrada frontal do rack, e não apenas no termostato fixado em outra parede. Há diferença relevante entre a temperatura média da sala e o ar que efetivamente alimenta o servidor. Pontos quentes no topo do rack ou em corredores sem contenção podem afetar somente parte do parque, o que torna o diagnóstico menos óbvio.
3. Ventiladores, dissipadores e filtros obstruídos
Poeira acumulada em ventiladores, dissipadores de calor e filtros reduz a troca térmica. Em ambientes industriais, escritórios próximos a vias movimentadas ou salas compartilhadas com estoque, essa contaminação costuma ocorrer mais rápido. Um fan com rotação irregular ou falha parcial pode não parar o equipamento imediatamente, mas transfere carga aos demais ventiladores e aumenta o desgaste do conjunto.
Verifique os registros de hardware no iDRAC, iLO ou ferramenta equivalente. Alertas de fan, temperatura de CPU, memória, controladora RAID e zona térmica ajudam a localizar o ponto de falha. A limpeza precisa ser feita com procedimento adequado e com o equipamento desligado quando necessário. Ar comprimido aplicado sem critério pode danificar ventoinhas ou espalhar resíduos para conectores e placas.
4. Pasta térmica degradada ou dissipador mal instalado
A interface entre processador e dissipador exige contato correto. Pasta térmica ressecada, quantidade inadequada de material ou um dissipador fixado fora da pressão especificada impedem a transferência de calor. Esse cenário é mais comum após troca de CPU, manutenção preventiva mal executada ou transporte do equipamento.
Não trate a substituição da pasta térmica como reparo genérico. Cada plataforma possui retenções, torque e sequência de instalação próprios. Em servidores corporativos, um encaixe incorreto pode afetar também módulos de memória, dutos de ar e sensores. O reparo deve respeitar a orientação do fabricante e a compatibilidade do chassi.
5. Carga de processamento acima da capacidade planejada
Nem todo superaquecimento começa na infraestrutura física. Uma máquina virtual em loop, uma consulta de banco de dados mal otimizada, backup executado no mesmo horário de pico ou processamento de IA sem capacidade prevista podem manter CPUs e GPUs próximas do limite por longos períodos. O servidor reduz automaticamente a frequência para se proteger, fenômeno conhecido como throttling, e a aplicação fica lenta antes mesmo de ocorrer uma parada.
Compare o momento do alerta com indicadores de utilização de CPU, memória, disco e rede. Se a temperatura acompanha picos de carga, talvez o problema seja dimensionamento, distribuição inadequada de máquinas virtuais ou falta de capacidade no cluster. Adicionar refrigeração sem revisar a demanda pode apenas adiar uma expansão inevitável.
6. Fonte de alimentação, energia ou firmware
Fontes com falha, módulos redundantes trabalhando fora do equilíbrio e alimentação elétrica instável também podem elevar a temperatura. Alguns servidores aceleram ventiladores ao detectar condição anormal de fonte, bateria, controladora ou sensor. O ruído maior dos fans, nesse caso, é consequência de uma proteção preventiva, não necessariamente a origem do defeito.
Firmware desatualizado pode apresentar leituras imprecisas ou curvas de ventilação inadequadas para componentes instalados. Antes de atualizar, avalie a janela de manutenção, a matriz de compatibilidade e o histórico de mudanças. Atualizações sem planejamento em equipamentos que sustentam serviços críticos também criam risco operacional.
7. Componentes incompatíveis ou configuração incompleta
Memórias, placas de rede, GPUs, controladoras e discos precisam estar dentro da compatibilidade térmica e elétrica da plataforma. Um componente de terceiros pode operar, mas provocar comportamento agressivo dos ventiladores por falta de telemetria reconhecida pelo firmware. Tampas removidas, dutos de ar ausentes e baias sem caddies também alteram o projeto de circulação interna.
Em equipamentos recondicionados, a procedência e a revisão técnica fazem diferença. Um servidor corporativo bem configurado pode oferecer excelente relação entre custo e desempenho, mas deve sair para produção com fans, heatsinks, fontes, trilhos e peças de fluxo de ar adequados ao modelo e à carga prevista.
8. Falha de monitoramento e manutenção reativa
A causa pode estar presente há semanas, mas só se torna visível quando alguém percebe lentidão ou escuta ventiladores em rotação máxima. Sem acompanhamento de temperatura, saúde de fans, consumo e eventos de hardware, a equipe atua depois que o risco já atingiu a operação. Monitoramento contínuo transforma variações térmicas em indicadores de manutenção programada.
Registre tendências, não apenas alarmes isolados. Uma CPU que passa de 62 °C para 78 °C sob a mesma carga, ao longo de poucos dias, merece investigação mesmo que ainda esteja abaixo do limite crítico. Essa leitura é especialmente relevante em ambientes híbridos, nos quais a indisponibilidade de um nó local pode afetar aplicações, backups e integrações com a nuvem.
Como diagnosticar sem aumentar a indisponibilidade
Comece preservando evidências. Reiniciar o servidor pode limpar eventos relevantes e dificultar a análise. Consulte os logs de gerenciamento remoto, confirme quais sensores geraram o alerta e relacione o horário a mudanças de carga, manutenção, falha elétrica ou alteração no ar-condicionado.
Em seguida, faça uma inspeção física controlada. Observe a direção do fluxo de ar, a presença de poeira, a integridade de tampas, dutos e caddies, além do estado dos ventiladores e fontes. Se houver odor de queimado, ruído mecânico, alerta de fonte ou temperatura em crescimento acelerado, reduza a carga ou mova os serviços conforme o plano de contingência. Não mantenha o servidor sob estresse esperando que o desligamento automático resolva o problema.
Para uma análise consistente, a equipe deve registrar pelo menos os seguintes dados:
- temperatura de entrada no rack e temperatura da sala;
- sensores de CPU, memória, discos, controladora e fontes;
- rotação e status de cada ventilador;
- utilização de CPU, memória, armazenamento e máquinas virtuais;
- eventos recentes de firmware, energia, manutenção e mudanças de configuração.
Com esses dados, fica mais fácil separar uma falha física de uma demanda acima do projeto. Isso evita trocas desnecessárias e direciona o investimento para o ponto que realmente protege a disponibilidade.
Prevenção que reduz custo e risco
A prevenção começa no dimensionamento. Um servidor não deve ser escolhido apenas pela quantidade de núcleos ou memória disponível hoje. É preciso considerar expansão, perfil de aplicações, densidade do rack, consumo, redundância elétrica e condição térmica do ambiente. Em muitos casos, distribuir a carga entre dois equipamentos ou revisar a virtualização custa menos do que recuperar uma parada causada por calor.
Defina manutenção preventiva com periodicidade ajustada ao ambiente, não por calendário fixo sem critério. Data centers com filtragem e controle ambiental podem exigir intervenções diferentes de uma sala de TI exposta a poeira. Inclua limpeza técnica, revisão de fans, checagem de heatsinks, atualização planejada de firmware e validação de alertas.
A MSServer apoia empresas na avaliação de servidores Dell, HP e IBM, peças de reposição, manutenção e monitoramento para que a infraestrutura opere com controle real. O recurso certo para seu projeto deve combinar capacidade, refrigeração, suporte e garantia, não apenas preço de aquisição.
Calor em excesso quase nunca surge sem aviso. Quando a equipe transforma telemetria, inspeção física e planejamento de capacidade em rotina, o servidor deixa de ser um ponto de preocupação e volta a cumprir sua função: sustentar a operação com previsibilidade.
