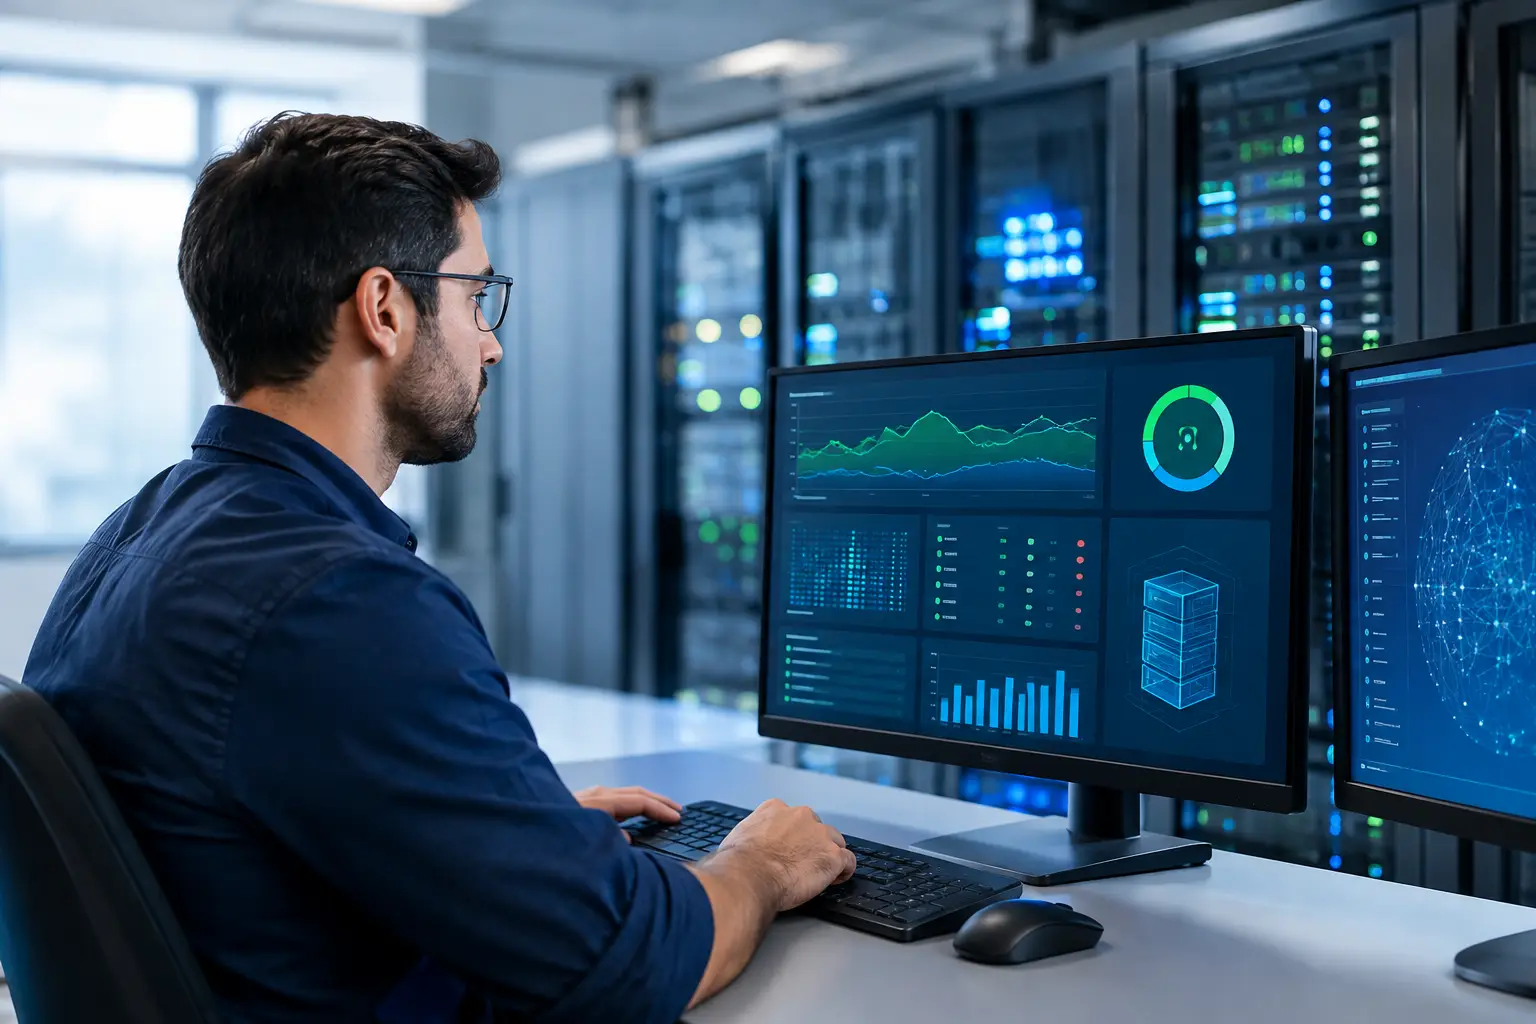
Uma fonte com oscilação, um fan com rotação irregular ou uma controladora elevando a taxa de erros pode parecer um detalhe isolado. Em um ambiente produtivo, porém, esses sinais costumam surgir antes de uma indisponibilidade que interrompe sistemas, compromete SLAs e mobiliza a equipe em regime de urgência. O futuro do monitoramento preditivo de servidores está em transformar esses sinais técnicos em decisões de manutenção antes que a falha chegue ao usuário.
Monitorar se o servidor está ligado e respondendo ao ping já não é suficiente para operações que dependem de ERP, banco de dados, virtualização, aplicações internas ou serviços de clientes. Disponibilidade real exige saber como o equipamento está se comportando, qual tendência seus indicadores apresentam e onde existe risco operacional. A mudança é clara: sair da reação ao incidente para a prevenção baseada em evidências.
O que muda no monitoramento preditivo de servidores
O monitoramento tradicional trabalha, na maior parte dos casos, com limites fixos. A CPU atingiu determinado percentual, a temperatura passou de uma faixa definida ou o espaço em disco ficou abaixo do mínimo estabelecido. Alertas desse tipo continuam necessários, mas eles normalmente informam que o problema já está em curso.
O monitoramento preditivo acrescenta contexto histórico e correlação entre eventos. Em vez de observar somente que a temperatura de um processador está alta, ele identifica se houve uma elevação progressiva ao longo das últimas semanas, se os fans aumentaram a rotação para compensar o calor e se a carga de trabalho permaneceu estável. Esse conjunto de informações pode indicar acúmulo de poeira, degradação térmica, falha de ventilação ou dimensionamento inadequado do equipamento.
O mesmo vale para discos, memórias, fontes e interfaces de rede. Uma unidade pode continuar operacional mesmo apresentando crescimento em setores realocados, latência fora do padrão ou erros de leitura. Uma fonte redundante pode manter o servidor ativo, mas a redundância já deixou de existir. Se a equipe só descobrir isso na próxima falha, o ambiente passa a operar com um risco desnecessário.
Em servidores Dell PowerEdge, HP ProLiant e IBM, as controladoras e ferramentas de gerenciamento disponibilizam telemetria valiosa sobre componentes físicos. A oportunidade está em centralizar esses dados, estabelecer uma linha de base de funcionamento e criar rotinas técnicas para agir sobre desvios relevantes.
Dados que antecipam falhas de hardware
Nem toda métrica tem o mesmo valor preditivo. Processar um grande volume de informações sem critério apenas amplia o ruído de alertas. O ponto central é acompanhar indicadores que afetam diretamente a continuidade da operação e relacioná-los ao perfil de uso de cada servidor.
Em armazenamento, merecem atenção a saúde SMART, erros de leitura e gravação, tempo de resposta, reconstruções de RAID, setores realocados e alertas da controladora. Em uma infraestrutura virtualizada, uma degradação gradual do conjunto de discos pode gerar lentidão percebida em várias máquinas virtuais antes de causar uma parada total.
No processamento e na memória, a análise deve combinar utilização, temperatura, throttling, erros corrigíveis e não corrigíveis de ECC, além de picos recorrentes de carga. Um servidor que opera com CPU constantemente próxima do limite não está necessariamente com defeito. Talvez a demanda tenha crescido e seja hora de redistribuir máquinas virtuais, ampliar recursos ou planejar uma atualização de plataforma.
Fontes, baterias de controladora, nobreaks, fans e placas de rede também precisam entrar na rotina. São componentes que muitas vezes recebem pouca atenção até provocarem uma ocorrência crítica. A leitura preventiva permite programar a troca, reservar a peça adequada e executar a manutenção em uma janela planejada, não durante uma madrugada de indisponibilidade.
Inteligência artificial ajuda, mas não substitui operação técnica
A inteligência artificial tende a ganhar espaço nesse cenário ao reconhecer padrões em grandes volumes de métricas e apontar anomalias difíceis de perceber manualmente. Ela pode comparar o comportamento atual com o histórico, estimar a probabilidade de falha de um componente e priorizar alertas conforme o impacto esperado no negócio.
Mas há um limite prático: modelos preditivos dependem da qualidade dos dados e do conhecimento do ambiente. Um alerta de anomalia não define, sozinho, se a ação correta é trocar um disco, atualizar firmware, revisar a climatização ou expandir capacidade. Essa decisão exige inventário atualizado, entendimento das dependências entre sistemas e validação por profissionais de infraestrutura.
Também não faz sentido aplicar algoritmos complexos onde faltam fundamentos. Sem agentes configurados, logs centralizados, alertas bem definidos, inventário de ativos e documentação de topologia, a inteligência artificial só acelerará interpretações incompletas. Primeiro, a operação precisa ter visibilidade. Depois, pode evoluir para análises avançadas.
O desafio dos ambientes híbridos e do legado
A realidade de muitas empresas brasileiras inclui equipamentos de gerações diferentes, servidores físicos dedicados, clusters de virtualização, cargas em nuvem pública e aplicações que não podem sofrer interrupção. Nesse contexto, monitoramento preditivo não pode ficar limitado ao hardware mais novo ou aos serviços em cloud.
Servidores seminovos e recondicionados de nível corporativo seguem sendo uma escolha economicamente eficiente quando passam por avaliação técnica, recebem peças compatíveis e contam com cobertura adequada. Porém, o ganho de custo-benefício só se mantém quando há acompanhamento de ciclo de vida. Um equipamento fora de garantia, sem histórico de manutenção e sem peças de reposição mapeadas pode se transformar em um ponto crítico da operação.
A estratégia correta varia conforme a criticidade. Um servidor dedicado que sustenta o banco de dados principal exige redundância, coleta detalhada e plano de contingência. Já um equipamento de homologação pode trabalhar com alertas mais simples. Tratar todos os ativos da mesma forma consome orçamento onde não é necessário e deixa lacunas onde o risco é maior.
Como preparar a infraestrutura para uma operação preditiva
A implantação deve começar por uma classificação dos serviços e ativos. Identifique quais servidores suportam sistemas críticos, quais dependem de componentes específicos e qual é o impacto financeiro ou operacional de uma parada. Sem essa priorização, a equipe tende a receber alertas com a mesma urgência, mesmo quando os riscos são completamente diferentes.
Depois, padronize a coleta de dados. Habilite interfaces de gerenciamento, registre eventos de hardware, acompanhe sensores de temperatura e energia, integre logs do sistema operacional e mantenha o inventário atualizado com modelo, número de série, configuração, versão de firmware e cobertura de garantia. Esse histórico é a base para detectar comportamento fora do padrão.
A etapa seguinte é definir fluxos de resposta. Um alerta de disco em degradação deve abrir uma ação objetiva: validar RAID, confirmar backup, separar a peça compatível, definir a janela e substituir o componente. Se cada ocorrência começa com uma investigação do zero, o ambiente ainda está reagindo, mesmo que possua muitas métricas disponíveis.
Por fim, revise periodicamente os limites, as tendências e a capacidade. Um crescimento contínuo de uso de armazenamento ou memória não é uma falha de hardware, mas pode se tornar uma indisponibilidade previsível se ninguém agir. Previsão de capacidade e manutenção preditiva precisam caminhar juntas.
Prevenção também melhora o controle de custos
O valor do monitoramento preditivo não está apenas em evitar uma parada grave. Ele também melhora a negociação de peças, reduz substituições feitas sem necessidade, prolonga a vida útil de ativos em boas condições e orienta investimentos com base em evidência técnica.
Trocar um servidor inteiro porque houve falha em um componente pode ser um desperdício. Por outro lado, insistir em uma plataforma que já apresenta recorrência de erros, baixa capacidade e suporte limitado pode custar mais do que uma renovação planejada. A decisão depende de desempenho, criticidade, disponibilidade de peças, garantia e horizonte de crescimento da empresa.
Para operações que precisam de acompanhamento contínuo, a MSServer combina fornecimento de servidores corporativos, peças de reposição, manutenção e monitoramento em tempo real. O objetivo não é acumular alertas em uma tela. É manter a infraestrutura disponível, com resposta técnica e previsibilidade de investimento.
O próximo incidente não precisa ser o momento em que sua empresa descobre um componente degradado. Comece pelos ativos críticos, estabeleça uma linha de base e transforme cada dado coletado em uma ação possível. Infraestrutura bem monitorada não depende de sorte para continuar operando.
